> ## Documentation Index
> Fetch the complete documentation index at: https://docs.hubtalk.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Промпт, модели и знания
> Общий промпт, переменные в авторском тексте, переопределения моделей, прогрев кэша, базы знаний и flex-режим.
# Промпт, модели и знания
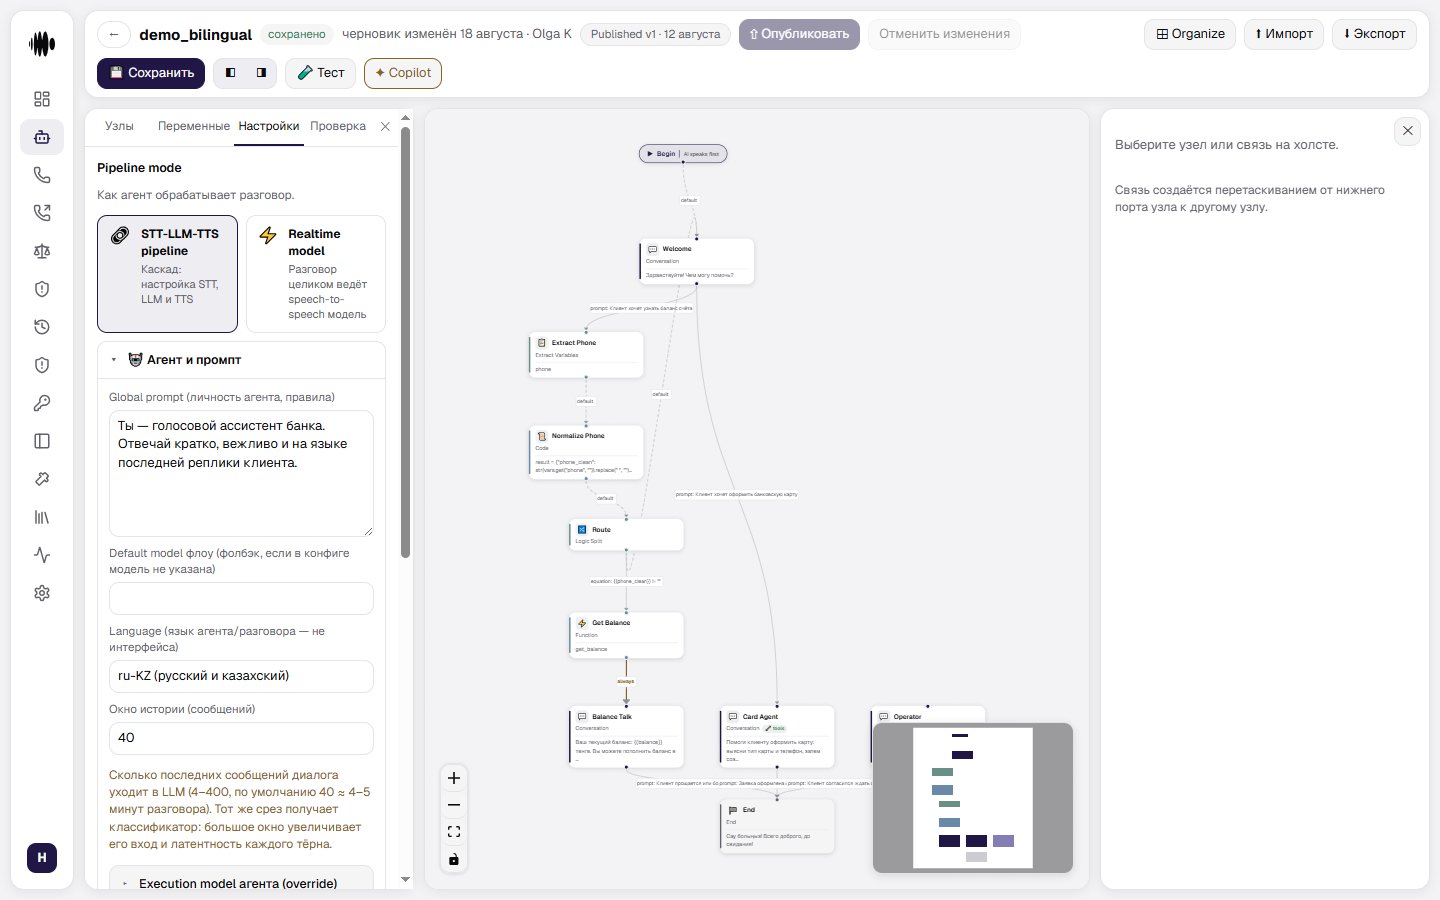
## Агент и промпт
* **«Общий промпт (личность агента, правила)»** — личность, правила, тон и общее поведение агента. Действует на протяжении всего разговора.
* **«Модель флоу по умолчанию (запасная, если в конфиге модель не указана)»** — берётся, когда модель не задана ни на узле, ни в конфигурации.
* **«Язык агента (язык разговора, не интерфейса)»** — на каком языке агент говорит; язык кабинета от этого не меняется.
* **«Окно истории (сообщений)»** — сколько последних сообщений диалога уходит в модель: от 4 до 400, по умолчанию 40 (примерно 4–5 минут разговора). Тот же срез получает классификатор, поэтому большое окно увеличивает задержку каждого хода.
* **Точка входа** — её задаёт узел **Begin** на холсте: его единственная связь ведёт к первому узлу диалога, там же выбирается, кто говорит первым.
 ### Переменные в авторском тексте
Плейсхолдер `{{имя_переменной}}` подставляется значением сессии **во всём тексте, который пишете вы**, а не только в инструкции узла:
* общий промпт агента;
* условия переходов, включая глобальные;
* сводка целей разговора;
* описания и аргументы инструментов и функций;
* поля извлечения переменных;
* промпт flex-режима;
* подсказка распознавания автоответчика;
* тексты обучающих примеров.
**Подстановку проходит и общий промпт, а не только инструкция узла.** Скрипт, положенный в общий промпт, доезжает до модели с подставленными значениями — дублировать его текст в инструкции узлов ради подстановки не нужно.
**Неизвестное имя остаётся текстом, а не превращается в пустоту.** Если переменной в звонке нет, модель увидит `{{имя}}` — ровно так же, как это всегда работало в инструкции узла. Пустая подстановка сделала бы опечатку автора невидимой: агент молча заговорил бы с дырой в фразе вместо явного сигнала, что переменная не пришла.
Непокрытые переменные кампании ловятся не здесь, а предупреждениями на шаге [запуска кампании](/ru/v4/platform/campaign-launch).
**На агентов без плейсхолдеров это не влияет вовсе.** Текст без `{{` рендерится сам в себя, поэтому кеш префикса промпта и его прогрев у таких агентов работают в полную силу. У агента, который подстановкой пользуется, префикс становится разным на каждом звонке — и прогрев его пропускает: греть текст, который никогда не запросят, значит завышать статистику попаданий.
**Когда модель отказывается отвечать, агент извиняется на языке звонка.** Если языковая модель отклонила ход, агент произносит короткую фразу-фолбэк вместо того, чтобы замолчать. Фраза подбирается под язык, который реально используется, по цепочке «свежее — раньше»: язык текущего хода, затем язык, установленный динамической переменной, затем язык прошлого хода, затем **«Язык агента»**. Выбор фразы ничего не стоит абоненту — ни лишней реплики, ни сетевого вызова. Язык, для которого своей фразы нет, пропускается, а не подменяется другим: абонент не услышит извинение на языке, на котором не говорил.
### Переопределение модели выполнения агента
Секция **«Модель исполнения агента (переопределение)»** задаёт модель для основных операций агента: генерации ответов, вызова инструментов и извлечения переменных. По умолчанию агент наследует конфигурацию модели от сценария или сервера.
Включите **«Переопределить для этого агента»**, чтобы задать ему отдельную конфигурацию. В переопределении можно задать модель, endpoint, API-ключ или переменную окружения, а также temperature. Настройки агента имеют приоритет над конфигурацией сервера.
Поле **«Модель флоу по умолчанию»** — устаревшая настройка, в которой указывается только имя модели. Оно применяется только тогда, когда в конфигурации сервера модель не задана. Оставьте переопределение выключенным, если модель должна управляться общей конфигурацией сценария или сервера.
### Переопределение модели классификатора агента
Секция **«Модель классификации агента (переопределение)»** задаёт модель, которая на каждом ходе диалога решает: перейти на другую ноду или остаться на текущей.
Включите **«Переопределить для этого агента»**, чтобы задать ему отдельную модель классификатора. Если переопределение выключено, классификатор наследуется из конфигурации сервера. Это чувствительный к задержке этап, поэтому обычно лучше использовать быструю модель без reasoning.
В отличие от модели выполнения, переопределение классификатора задаётся на уровне агента и не заменяется настройкой классификатора на уровне отдельной ноды.
### Тир обслуживания
У слота модели — и у агентского, и у того, что задан на узле, — есть селект **«Тир обслуживания»**: с каким приоритетом поставщик обслужит запрос. Это не другая модель, а та же самая, обслуженная быстрее или дешевле:
* **«По умолчанию провайдера (не передаётся)»** — платформа тир не просит, поведение прежнее;
* **priority** — за скорость, дороже;
* **flex** — дешевле, но медленнее;
* **auto** — выбор остаётся за поставщиком;
* **default** — явная просьба обслужить обычным тиром.
Селект показывается только у моделей с признаком **«Поддерживает тиры обслуживания (OpenAI service\_tier)»**; у остальных его нет.
Подсказка рядом с селектом предупреждает о неудачных сочетаниях: **flex** на живом ходу разговора добавит абоненту ожидания, а **priority** там, где ответа никто не ждёт — в фоновой аналитике, — просто потратит деньги. Это подсказка, а не запрет.
**Платится фактический тир, а не запрошенный.** Под нагрузкой поставщик может обслужить запрос тиром ниже, и в расходе окажется именно он. Если цена применённого тира в справочнике не задана, строка расхода говорит **«нет данных»** — считать по базовой ставке значило бы показать неправильную сумму вместо честного пробела.
## Прогрев LLM
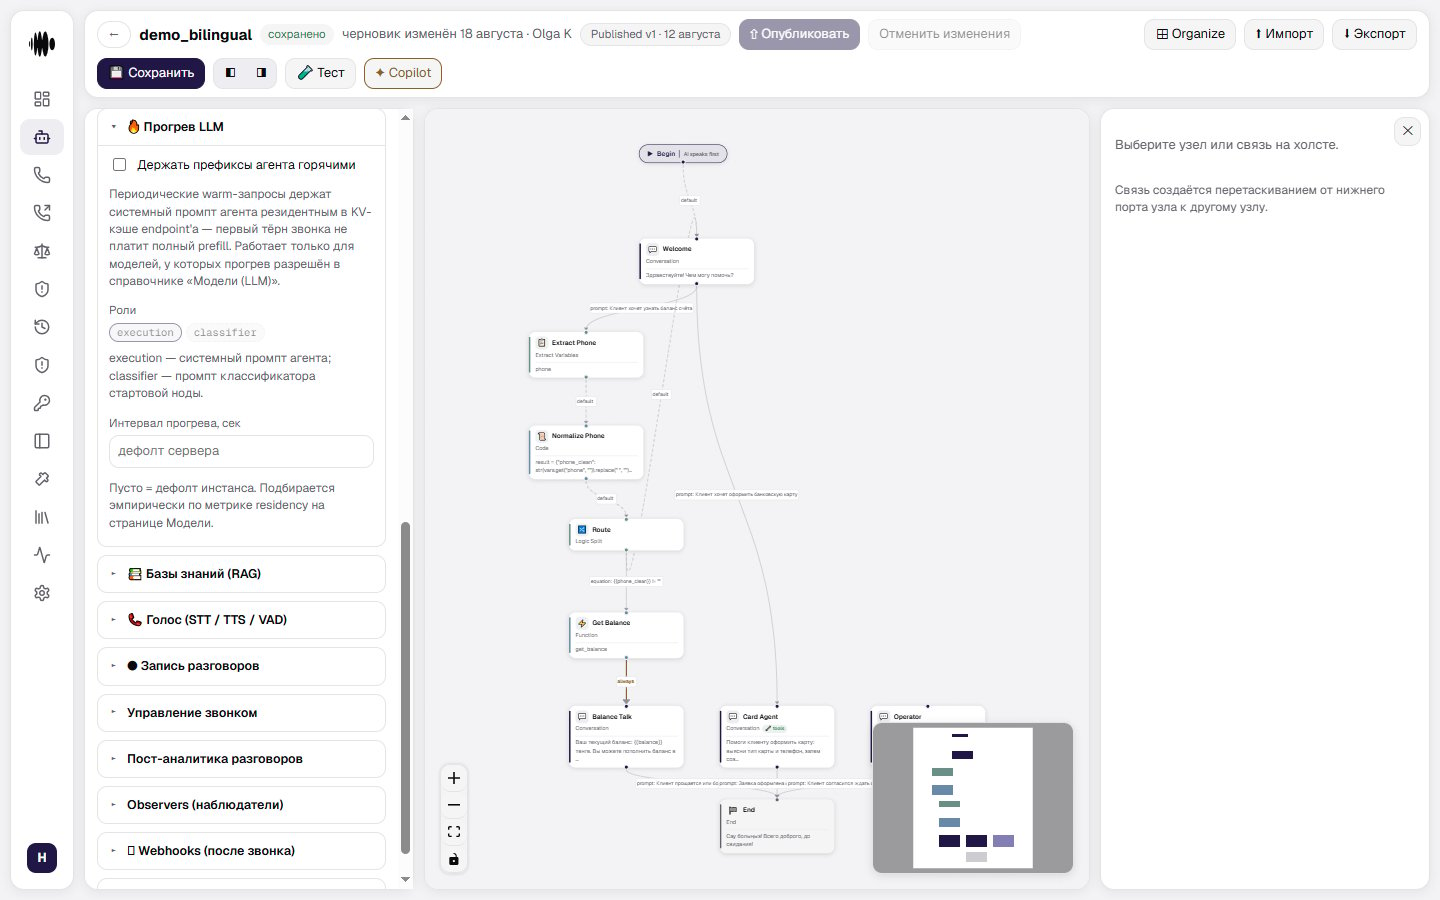
Прогрев поддерживает префиксы системного промпта агента в KV-кэше провайдера модели. Благодаря этому при первом ходе разговора модели нужно обрабатывать меньше контекста, и агент может ответить быстрее.
* **«Держать префиксы агента горячими»** — включает периодические прогревочные запросы. Выключите, если лишний трафик не нужен.
* **«Роли»** — какой именно промпт держать в кэше: `execution` — системный промпт агента, `classifier` — промпт классификатора стартового узла.
* **«Интервал прогрева, сек»** — частота запросов. Пустое поле означает дефолт сервера.
Прогрев работает только с моделями из справочника моделей.
 ## Базы знаний (RAG)
У агента есть набор баз знаний по умолчанию. Он используется всеми нодами Conversation, если для конкретной ноды не задана собственная база знаний.
* **«Базы знаний»** — поиск и добавление баз в набор агента по умолчанию.
* **Кнопка +** — создаёт новую базу прямо из панели настроек.
* **Пустой набор** — поиск идёт только на тех узлах, у которых задан свой набор.
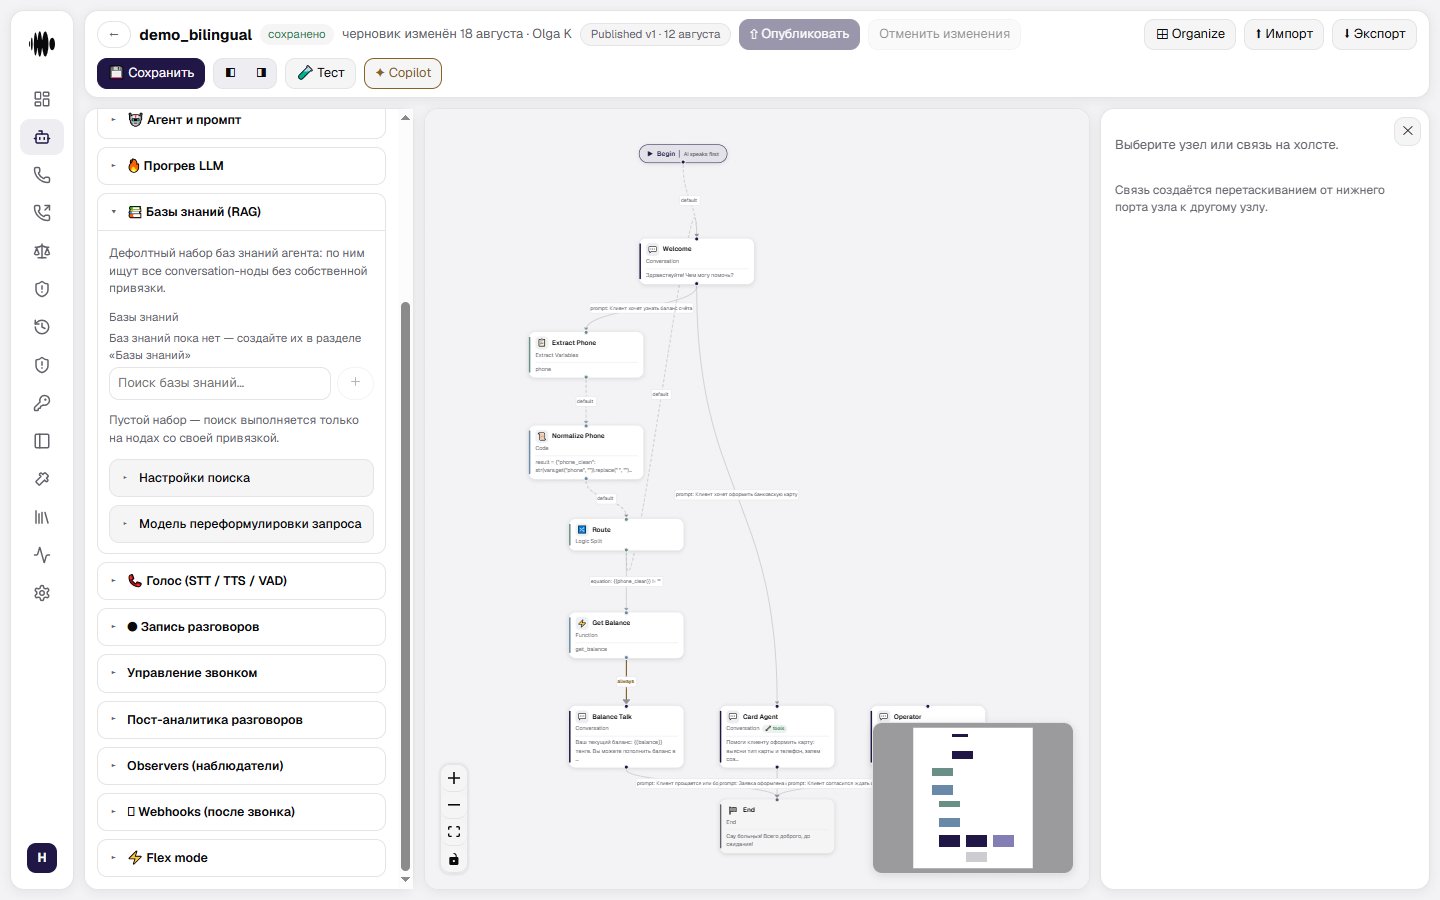 ### Настройки поиска
* **«Тип поиска»** — способ поиска по выбранным базам; значение **«по умолчанию (hybrid)»** объединяет несколько сигналов.
* **«Порог похожести (0..1)»** — минимальная релевантность результата. Чем выше, тем меньше находок и тем они точнее.
* **«Максимум результатов (1..100)»** — потолок числа находок.
* **«Переформулировка запроса (LLM)»** — переписывать ли запрос перед поиском: **«По умолчанию (наследовать)»**, **«Выключена (фильтр + склейка)»** или **«LLM-переформулировка»**.
### Модель переформулировки запроса
Отдельная модель используется, когда выбрана **«LLM-переформулировка»**. Если отдельная модель не задана, используется модель классификатора с быстрыми настройками и низкой temperature.
* **«Переопределить для этого агента»** — включает отдельную модель переформулировки вместо унаследованной настройки.
## Flex mode
**Flex mode** передаёт весь сценарий модели как единый структурированный промпт вместо обработки отдельных частей только через стандартный поток нод.
* **Flex mode** — включает обработку полного сценария как единого структурированного промпта.
* **Сводка компонента** — после включения показывает количество нод и примерный объём промпта в токенах, например `2 nodes, ~389 prompt tokens`.
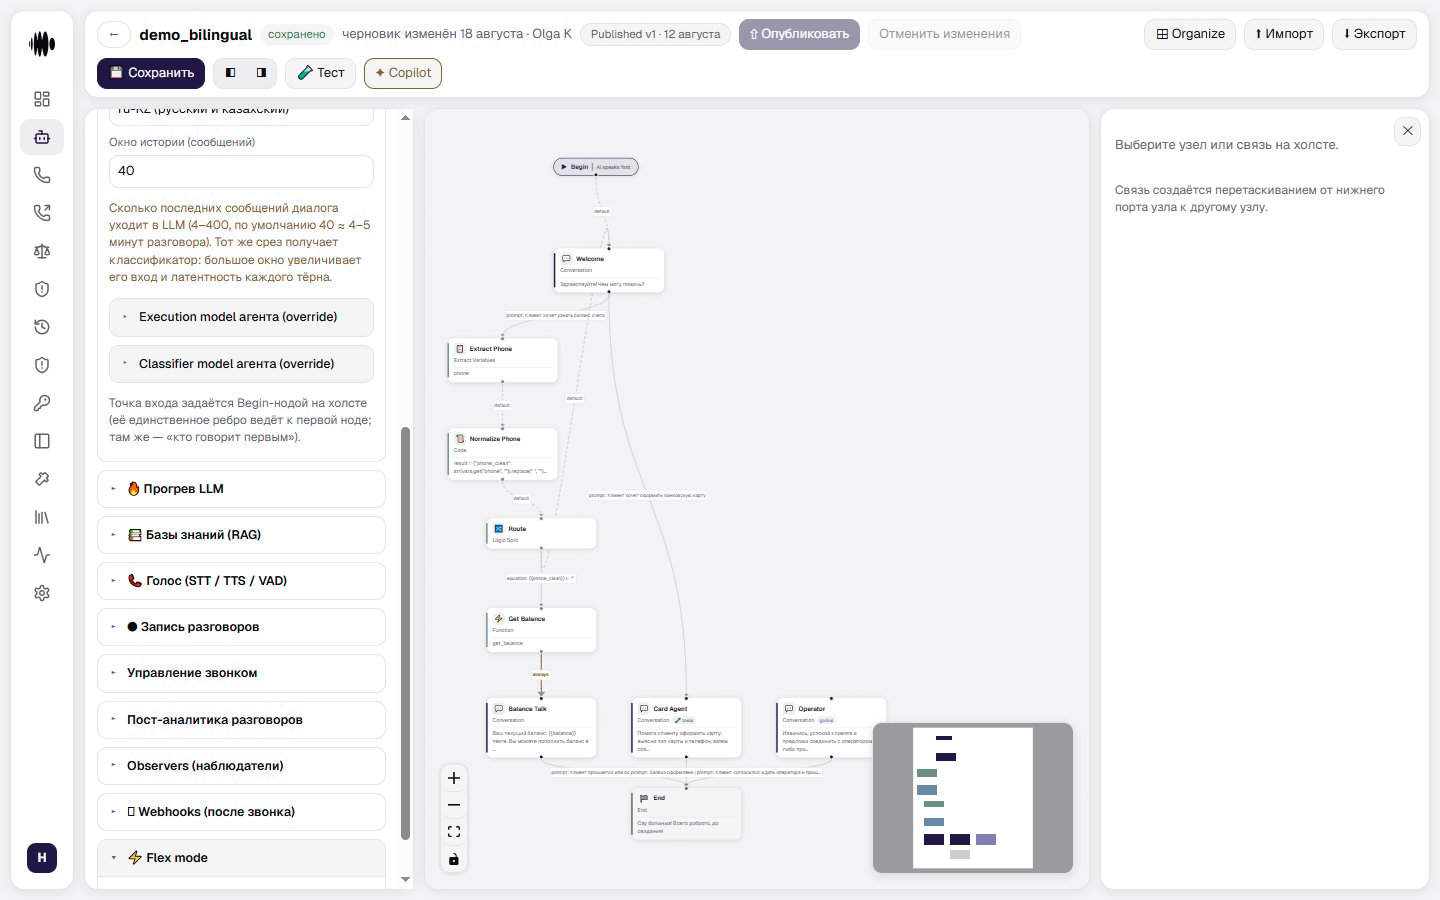 Используйте сводку, чтобы оценить размер сгенерированного промпта до запуска агента. Оставьте Flex mode выключенным, если для агента лучше подходит стандартная обработка сценария по нодам.