> ## Documentation Index
> Fetch the complete documentation index at: https://docs.hubtalk.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Правки фраз и паузы
> Словарь замен организации и разметка пауз [pause N] в текстах агента.
# Правки фраз и паузы
## Правки фраз
Отдельный раздел кабинета **«Правки фраз»** — словарь организации из пар «неправильно → правильно». Замена **буквальная**: платформа ищет ровно ту строку, что вы записали, и ставит на её место вашу. Регулярных выражений здесь нет намеренно — словарь ведут не программисты, а цена ошибки в регулярке выше пользы.
* Правило можно привязать **к одному агенту**; пустая привязка означает «все агенты организации».
* Правка применяется **и к звуку, и к тексту в истории**: абонент слышит исправленную фразу, и в транскрипте стоит она же.
* **Словарь живой.** Правки не замерзают в снимке сессии: изменили словарь — следующая же реплика идёт исправленной, перезапускать ничего не нужно.
* В панели голоса агента есть **тумблер**, включающий словарь для этого агента. **По умолчанию он выключен** — существующие агенты ничего не заметили.
Зачем это нужно: там, где модель одна на все языки, а абоненты говорят на своём, одни и те же грамматические ошибки повторяются из звонка в звонок. На боевых данных клиента ошибка встречалась в 8,9 % звонков, и **четыре правила закрыли 64 %** из них. Промпт такую регулярность лечит ненадёжно, а замена — детерминирована.
**В realtime-режиме словарь не действует.** Там речь синтезируется моделью целиком, и точки, в которой можно подменить текст перед озвучиванием, просто нет.
## Паузы в речи
Агент, читающий номер телефона или сумму на одном дыхании, звучит как машина. Напишите между словами `[pause N]`, где `N` — секунды от 0,1 до 3,0, и агент остановится в этом месте: `Наш номер — восемь [pause 0.4] шесть шесть [pause 0.4] два два.` Регистр слова и лишние пробелы значения не имеют, дробная часть отделяется точкой. Значение округляется до ближайших 0,05 с, а выходящее за диапазон подтягивается к границе: `[pause 5]` прозвучит как три секунды, `[pause 0]` — как 0,1. Из-за паузы фраза не отклоняется никогда.
Тег работает в фиксированном тексте узла, в генерируемых репликах и во всём остальном, что агент произносит вслух: первой реплике, напоминаниях при тишине, фразе после неудавшегося перевода, прощании конечного узла. Паузы может расставлять и сама модель — опишите в промпте, когда пауза нужна, и приведите тег как пример; написанный моделью тег обрабатывается точно так же, как набранный вами. Copilot тег знает и предложит `[pause N]`, а не форму конкретного провайдера.
**Что услышит абонент, зависит от голоса.** Там, где голос умеет паузу точной длины — ElevenLabs на всех моделях, кроме `eleven_v3`, Cartesia, Inworld, Azure, — пауза настоящая, с точностью до сетки 0,05 с. Там, где не умеет — OpenAI, Soniox, собственный голос `cybernet`, ElevenLabs `eleven_v3`, — платформа ставит вместо паузы знак препинания: до 0,4 с запятую, от 0,4 с многоточие. Остановка слышна, но её длина принадлежит голосу: по замерам знак препинания даёт от 0,18 до 0,64 с, поэтому `[pause 2]` на OpenAI звучит примерно как 0,6 с и неотличим от `[pause 0.5]`. Тишину платформа аудио не вставляет — на прослушиваниях это звучало так, будто рвётся связь.
Голос, заданный на узле, и резервный голос, включающийся при недоступности основного, получают паузу в той форме, которую понимает именно их голос: тег компилируется для каждого голоса отдельно, а не один раз на агента.
**У плотности есть потолок.** До ElevenLabs и Cartesia настоящими доходят три паузы на запрос (двадцать у Inworld, без предела у Azure); четвёртая и следующие, считая слева направо, становятся пунктуацией. От предложения, набитого тегами, голоса начинают сбоить, а для номера телефона трёх хватает, если сгруппировать цифры.
**`[pause]` без числа удаляется, а не произносится.** Как и любая неразобранная конструкция, начинающаяся с `[pause`: само слово вслух не читается ни при какой опечатке. Квадратная скобка, за которой не следует `pause`, остаётся текстом — `[1, 2, 3]` по-прежнему читается как «один, два, три». Старая форма `` продолжает работать и означает ровно то же на любом голосе, включая те, что её никогда не понимали, — переписывать существующие тексты не нужно; недописанный `
**Где тег ничего не делает.** В чат-тесте и текстовых каналах речи нет, останавливать нечего, а человеку реплика показывается без тега. У агента в **realtime-режиме (speech-to-speech)** отдельного шага синтеза нет: разметка вырезается из инструкций до того, как они попадут в модель, а валидатор агента выдаёт предупреждение `realtime_pause_markup` по каждому месту, где она стоит, — предупреждение, а не запрет на публикацию.
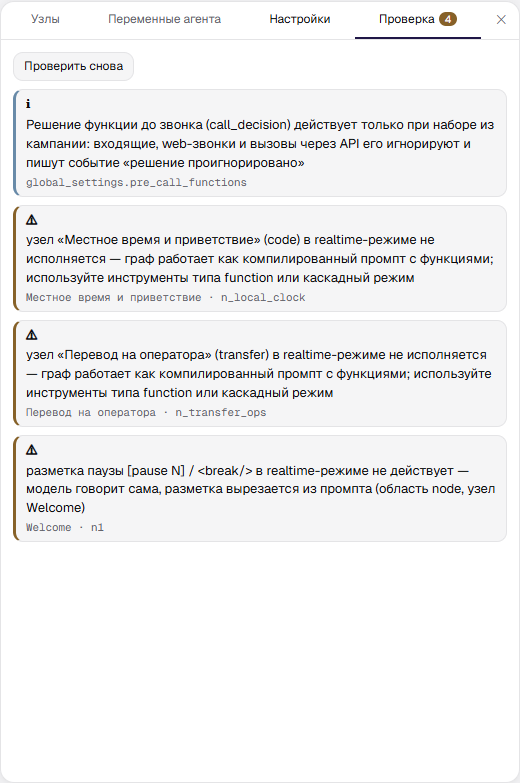 Везде, где разговор показывается текстом — живой транскрипт тестового звонка, [История звонков](/ru/v4/platform/campaign-history), выгрузки сессий, отчёты и содержимое ваших [вебхуков](/ru/v4/webhooks), — слова агента показаны без тега. Лог чанков синтеза хранит скомпилированный текст: по нему работают пере-синтез и denylist TTS-кэша.
**Что об этом говорит звонок.** Событие `pause_markup` со статусом *warning* пишется на тёрн **только если компиляция что-то потеряла**: `density_capped` — сработал потолок и лишние паузы стали пунктуацией; `value_clamped` — значение вне 0,1–3,0 подтянули к границе; `markup_dropped` — удалена неразобранная конструкция или битый `` и 1 у запятой. Счёт самого провайдера будет отличаться примерно на десять символов на каждую паузу.
**Какой длины делать.** 0,3–0,5 с между группами цифр, после имени, перед «верно?» — это читается как вдох. 0,8–1,2 с перед вопросом, требующим решения, или после плохой новости. Больше двух секунд — почти никогда: по телефону такая тишина означает «связь пропала?», и люди начинают говорить поверх агента. И не в каждом предложении — пауза работает потому, что остальная речь течёт.