

Настройка агента
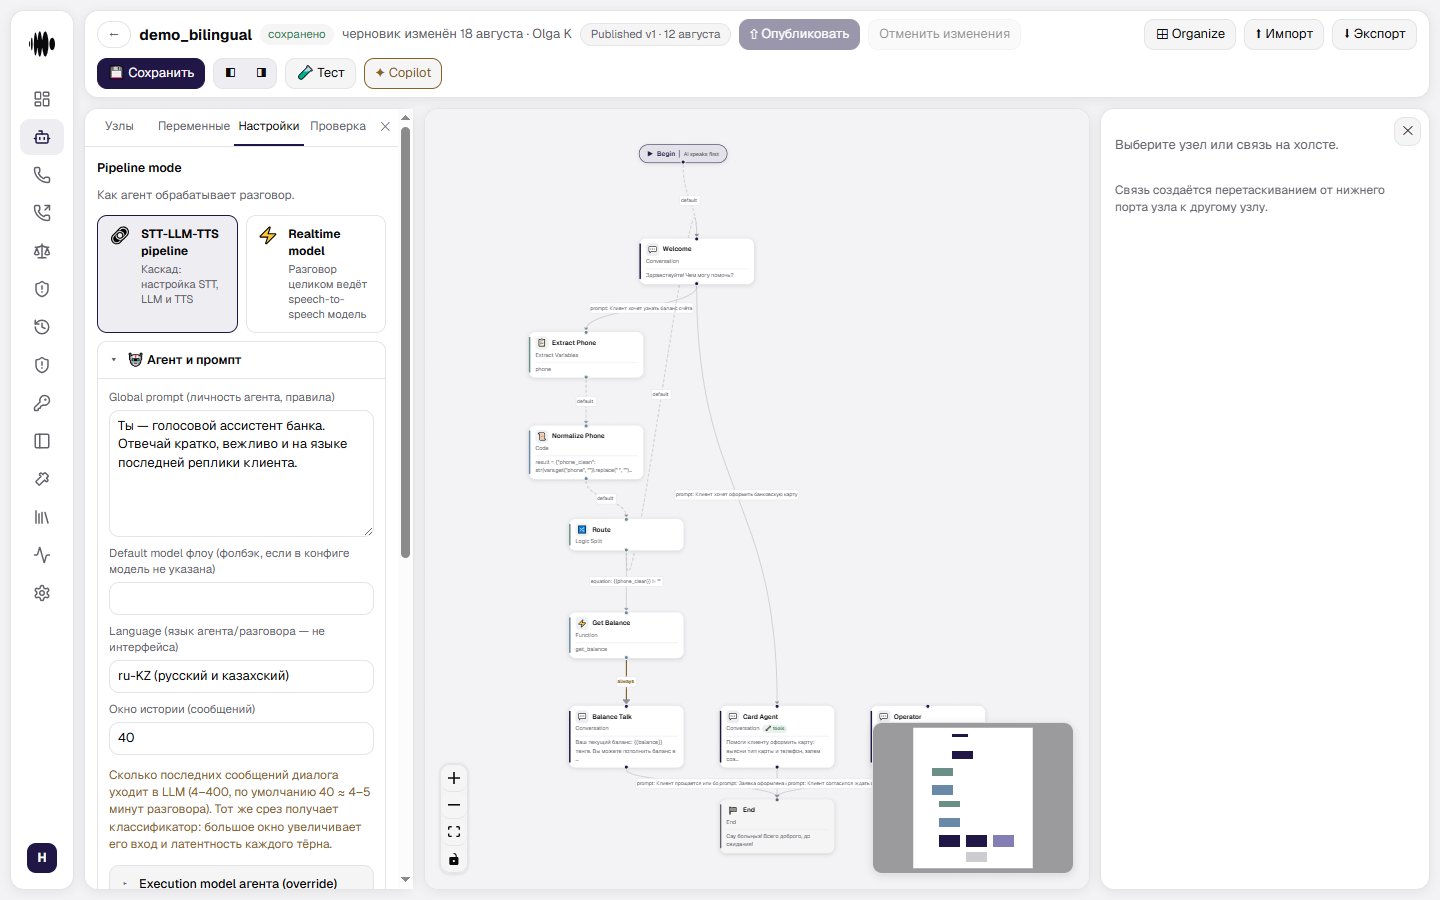
Настройки агента живут во вкладке «Настройки» в конструкторе. Откройте агента, перейдите на неё и настройте параметры, которые определяют обработку разговоров, речь агента, работу с базами знаний и управление звонками. Настроек много, поэтому они разложены по отдельным страницам — список ниже. Здесь остаётся только то, что нужно решить первым.Режим Pipeline
Выберите, как агент будет обрабатывать разговоры:- STT-LLM-TTS pipeline — настройте отдельно распознавание речи, языковую модель и синтез речи.
- Realtime model — используйте модель, которая обрабатывает речь в реальном времени по принципу speech-to-speech.
Где что настраивается
Промпт, модели и знания
Общий промпт и подстановка переменных в авторский текст, модель выполнения и классификатора, тир обслуживания, прогрев кэша, базы знаний, flex-режим.
Голос: STT, TTS и VAD
Распознавание и синтез речи, детектор речи и перебивания, фоновый звук, определение языка хода, нормализатор перед синтезом.
Правки фраз и паузы
Словарь замен организации и разметка
[pause N]: как агент звучит, когда читает номера и суммы.Запись и управление звонком
Запись разговора и её хранение, лимит длительности, напоминания при тишине, фраза при неудачном переводе.
Цели разговора
Что должно быть установлено в разговоре, как платформа отмечает выполненное и чего механизм принципиально не делает.
Аналитика, наблюдатели и вебхуки
Разбор после звонка и пользовательские поля, наблюдатели с реакциями, post-call вебхуки.