Голос: STT, TTS и VAD
Настройки STT, TTS и VAD хранятся в сценарии и применяются к звонкам. Провайдеры выбираются из настроенных каталогов. Ключи провайдеров хранятся в конфигурации окружения, а self-hosted endpoint’ам ключ провайдера не нужен. Большая часть этих настроек — в карточке «Голос» вкладки «Настройки»:- «Распознавание речи · модель ASR» — модель распознавания; её параметры — за шестерёнкой «Параметры STT».
- «Синтез речи · голос» — голос агента; голос, его модель и настройки выбираются в окне выбора голоса, а формат вывода и аварийный резерв — за шестерёнкой «Параметры TTS».
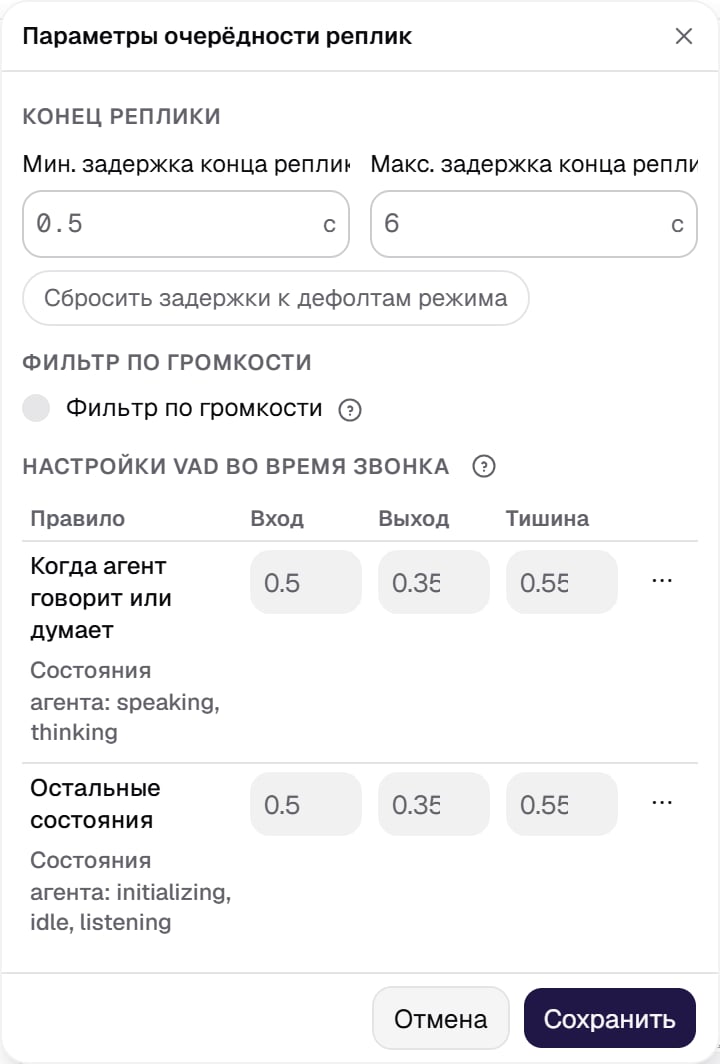
- «Очерёдность реплик» — перебивания, «Активное слушание», «Фоновый звук» и «Правки фраз»; детектор речи — за шестерёнкой «Параметры очерёдности реплик».
- «Аудиовход · дополнительно» — сворачиваемый блок под карточкой.
STT
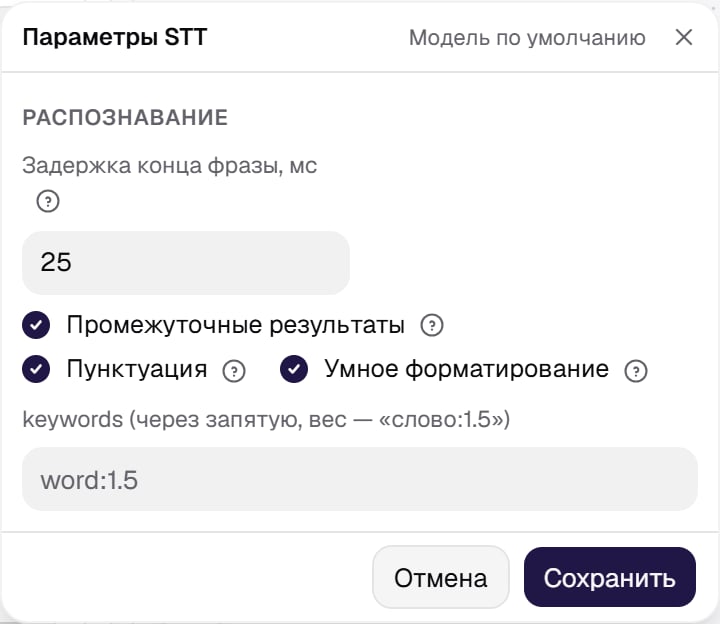
STT (speech-to-text) преобразует речь абонента в текст для агента. Модель распознавания выбирается в «Распознавание речи · модель ASR» ссылкой на запись справочника ASR-моделей; рядом показан её провайдер. Модель, помеченную устаревшей, кабинет подписывает прямо в поле. Отдельного языка у распознавания нет: оно слушает все языки агента. Шестерёнка «Параметры STT» показывает выбранную модель в заголовке и содержит:- У моделей Deepgram ещё «Задержка конца фразы, мс», флажки «Промежуточные результаты», «Пунктуация» и «Умное форматирование». «Промежуточные результаты» значат, что расшифровка приходит по ходу речи, а не одним куском в конце. У пакетных моделей промежуточных результатов нет: реплика распознаётся целиком, когда абонент договорил.
- keywords (через запятую, вес — «слово:1.5») — слова-подсказки, которые распознаванию стоит слышать точнее: названия, термины, аббревиатуры. Поле есть у моделей Deepgram, Cybernet, Soniox, Azure, AssemblyAI и Gladia; вес через двоеточие понимает Deepgram. Как писать подсказки для моделей Cybernet и примеры — в уроке «Голос».
- «Параметры модели ASR» — параметры провайдера у выбранной записи справочника, только для чтения.
- «Переопределение параметров провайдера (JSON)» — собственные значения этого агента поверх параметров записи; см. ниже.
Свои параметры модели у одного агента
Запись справочника несёт одни и те же параметры провайдера для всех агентов, которые её используют. Когда одному агенту нужно другое значение одного из них, заводить для него отдельную запись справочника больше не нужно: впишите разницу в «Переопределение параметров провайдера (JSON)».- Переопределение накладывается на запись по ключам. Ключ верхнего уровня в переопределении заменяет значение записи по этому ключу; остальные ключи записи остаются как есть. Пишите только те ключи, которые хотите поменять.
keep_tagsиnormalize_numbersпринимают толькоtrueилиfalse. Другое значение отклоняется: «keep_tags и normalize_numbers принимают только true или false».- Переопределение привязано к выбранной записи. Выбор другой ASR-модели его сбрасывает, как и отказ от справочника; повторный выбор той же записи — нет. Массовая замена записи справочника у агентов переопределение сохраняет.
- Оно замораживается при публикации вместе с остальным агентом: опубликованная версия хранит итоговые параметры, с которыми её опубликовали.
TTS
TTS (text-to-speech) преобразует текстовые ответы агента в аудио. Голос агента задаётся в группе «Синтез речи · голос»: кнопка со значением открывает окно выбора голоса. В этом окне выбираются голос, его модель, скорость речи агента и тонкая настройка звучания. Шестерёнка «Параметры TTS» хранит то, что относится к агенту, а не к голосу: формат вывода и аварийный резерв. Отдельного языка у синтеза нет: голос говорит на текущем языке звонка.Окно выбора голоса
Окно «Выберите голос» состоит из двух колонок; в шапке — имя агента и его языки.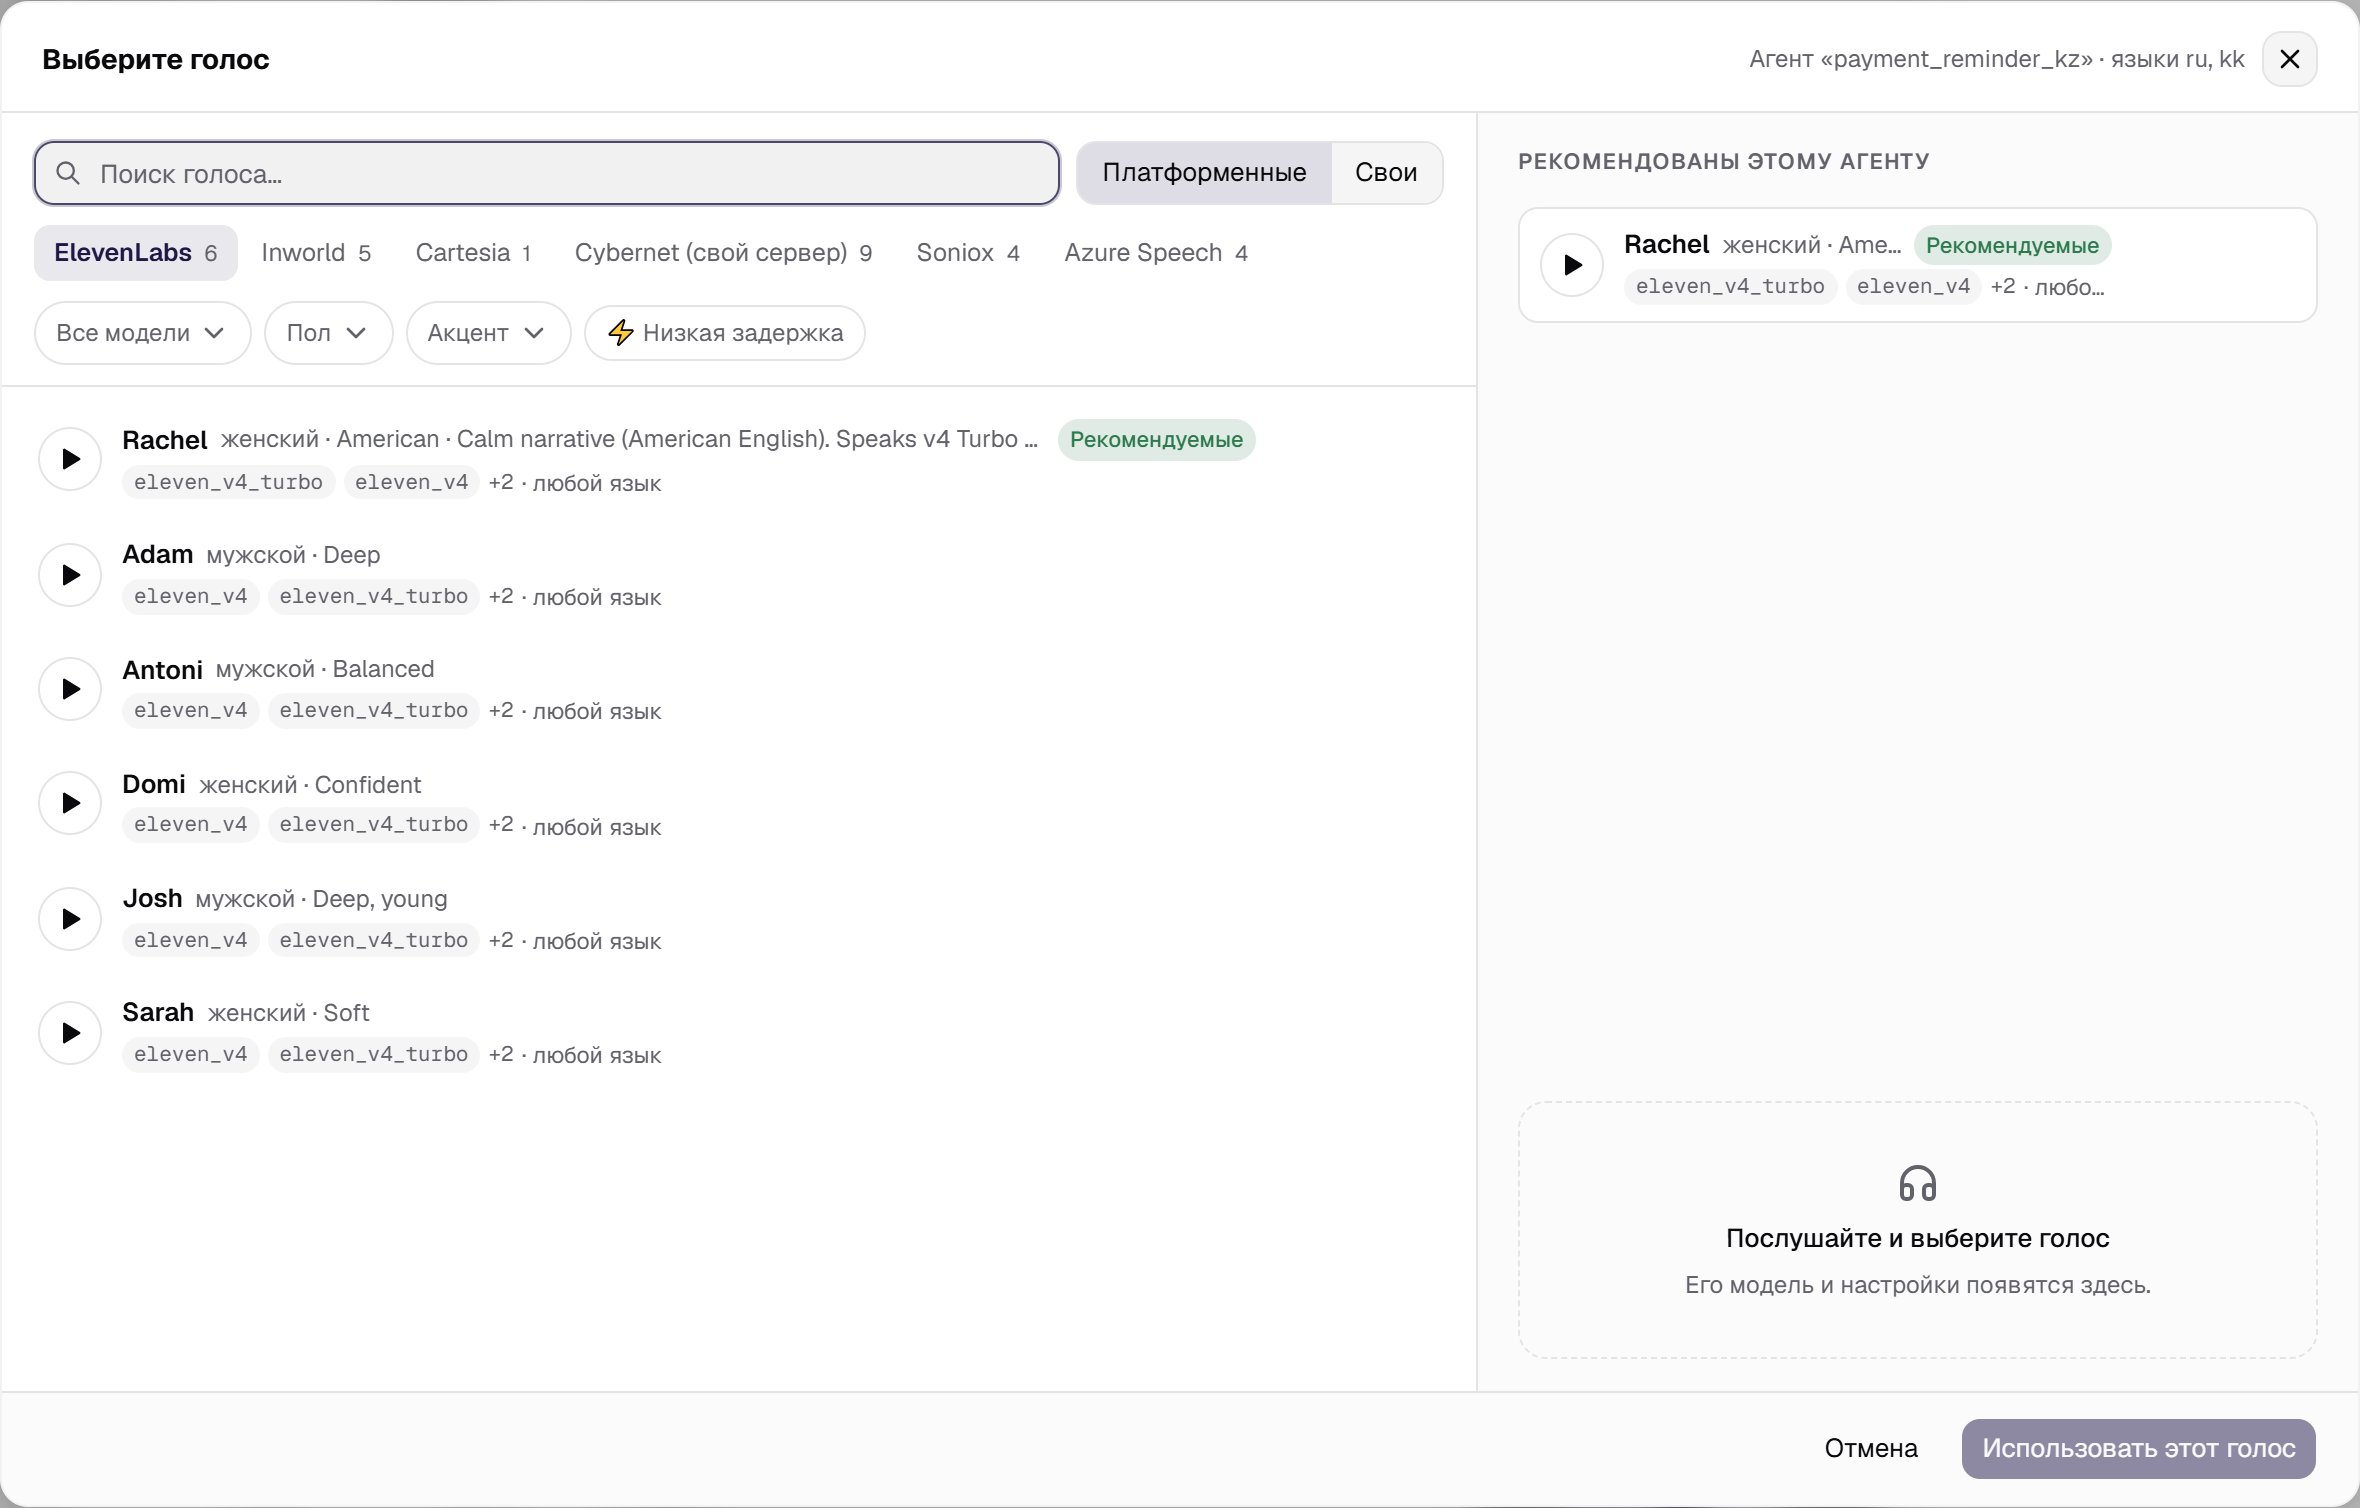
- «Поиск голоса…» — по имени, идентификатору голоса, модели, провайдеру и описанию.
- «Платформенные» / «Свои» — источник голосов. Переключатель появляется, когда в справочнике есть голоса обоих видов.
- Вкладки провайдеров — ElevenLabs, Cartesia, Inworld и другие, с числом голосов у каждого. Окно открывается на провайдере текущего голоса.
- Фильтры: «Модель» — голоса, которые умеют звучать на выбранной модели; «Пол»; «Акцент» — если у голосов вкладки он указан; «⚡ Низкая задержка». Когда в фильтре «Пол» или «Акцент» выбрано значение, голоса без этой пометки скрываются.
- Строка голоса — кнопка прослушивания ▶, имя, пол, акцент и описание, пометки «Рекомендуемые», «устарел» и «свой», модели, на которых может звучать голос, и число языков. Рекомендуемые голоса стоят вверху списка, устаревшие — внизу.
- Пока голос не выбран, панель показывает блок «Рекомендованы этому агенту» — рекомендуемые голоса текущей вкладки с учётом фильтров.
- Щелчок по строке выбирает голос. Панель показывает его имя с большой кнопкой прослушивания, провайдера, пол, акцент, языки и пометки «Без потока» и «Без word-timing», если они относятся к голосу. Список показывает только голоса, которые поддерживают все языки агента хотя бы на одной своей модели. Текущий голос, который перестал подходить, стоит в списке первым с пометкой «Не поддерживает: …».
- «Модель» — карточки моделей, если голос допускает несколько. Собственная модель голоса отмечена «модель записи».
- «Скорость» — скорость речи агента; пустое поле — значение провайдера. У голоса cybernet при 0,9 и ниже кабинет предупреждает, что качество голоса падает. Допустимый диапазон у провайдера свой — см. Настройки голоса вне диапазона провайдера.
- «Тонкая настройка» — раскрывающийся блок: у голоса ElevenLabs — его настройки звучания, у голоса с паспортом параметров — поля паспорта; см. Свои параметры голоса для одного агента.
- «Для разработчика» — раскрывающийся блок: «Параметры вне паспорта (JSON)», строка «провайдер · идентификатор голоса · модель» и «Параметры голоса из справочника» — собственные параметры голоса, только для чтения.
Прослушивание голоса
Кнопка ▶ проигрывает образец — короткое приветствие на основном языке агента; подсказка в панели называет язык образца. Если голос этот язык не поддерживает, приветствие звучит на одном из языков голоса, а при отсутствии подходящего — на английском. Образец звучит на модели, выбранной в карточке модели или в фильтре «Модель», а без выбора — на собственной модели голоса. Скорость и тонкая настройка на образец не влияют: он показывает голос с параметрами из справочника. Одновременно звучит один образец; повторное нажатие ставит его на паузу. У голосов Soniox и Azure образца нет: кнопка неактивна, а подсказка при наведении объясняет, что у провайдера нет синтезатора вне звонка. Если образец не загрузился, под списком появляется строка с причиной.Что сбрасывает выбор другого голоса
Модель, настройки ElevenLabs, поля паспорта и параметры в «Для разработчика» привязаны к голосу. Когда в окне выбран другой голос, панель начинает заново: собственная модель голоса, у ElevenLabs — значения по умолчанию из таблицы ниже, без своих параметров. Скорость агента сохраняется. Если вернуться к текущему голосу, панель снова покажет всё, что у него было задано.Голос вне справочника
Голос выбирается только из справочника, ручного ввода нет. Если агент хранит голос без ссылки на справочник, кнопка группы показывает «Вне справочника» с провайдером и идентификатором голоса. Такой голос звучит в звонках, но в кабинете он только для чтения: чтобы настроить голос, выберите его из справочника.Шестерёнка «Параметры TTS»
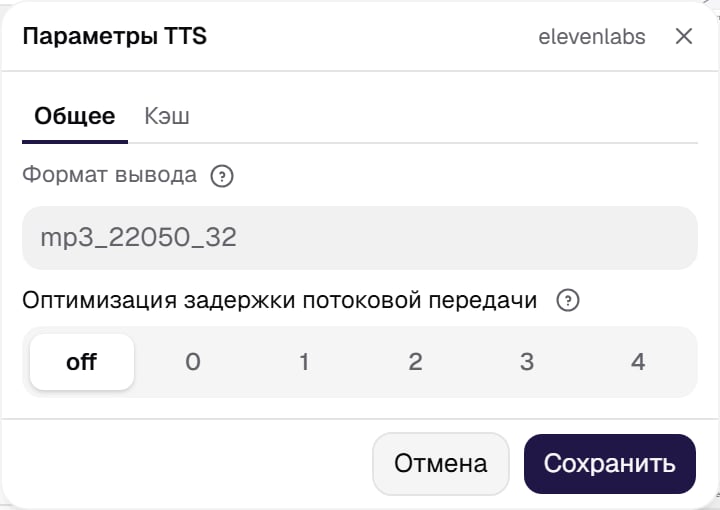
Шестерёнка показывает в заголовке голос и провайдера. На вкладке, где есть значение не по умолчанию, стоит точка. «Общее»- «Формат вывода» — пусто — дефолт плагина.
- «Оптимизация задержки потоковой передачи» — у голоса ElevenLabs: off или 0–4.
Свои параметры голоса для одного агента
Работает так же, как для модели распознавания выше. Значения задаются в окне выбора голоса:- Поля паспорта — в «Тонкой настройке», если у голоса есть паспорт параметров. Каждый параметр, который паспорт объявляет для выбранной модели, получает своё поле: ползунок, список, число, текст или переключатель. Рядом с полем видно, откуда значение: «своё значение», «значение записи» или «по умолчанию вендора»; параметр с пометкой «задаётся записью» изменить нельзя. Значение неверного типа, вне диапазона или не из допустимых вариантов подсвечивается и не сохраняется.
sample_rateу голоса cybernet — частота синтеза: 8000, 16000, 22050 или 24000 Гц, по умолчанию 8000. В телефонном звонке частота выше 8000 качества не добавляет — линия всё равно передаёт 8 кГц; 24000 — для веб-звонков и виджета.- «Параметры вне паспорта (JSON)» — в «Для разработчика»: ключи, которых паспорт не знает, а у голоса без паспорта — все ключи, которые нужно поменять, например
{"apply_text_normalization": "on"}. Ключ паспорта здесь отклоняется — он задаётся своим полем в «Тонкой настройке». У голоса cybernet паспорт строгий, и этого поля нет.
- Они накладываются на голос из справочника по ключам. Ключ верхнего уровня заменяет значение голоса, остальные ключи остаются как есть.
- Они переживают сохранение и публикацию.
- Они привязаны к выбранному голосу. Выбор другого голоса их сбрасывает — вместе с выбранной «Моделью».
- Они действуют только на голос самого агента. У голоса ноды свои значения — см. Параметры модели и голоса ноды; резервный голос их не получает.
- Они входят в ключ TTS-кэша: их правка меняет, какие фразы берутся из кэша.
- Параметр, отвергнутый паспортом — неверный тип, вне диапазона, не из допустимых вариантов, задаётся записью или недоступен для выбранной модели, — блокирует публикацию. Исправьте значение в окне выбора голоса, в «Тонкой настройке» или «Для разработчика».
- Параметр, которого нет в паспорте, — предупреждение: он уходит провайдеру без проверки.
- Модель, которой нет в списке моделей голоса, — предупреждение: публикуется собственная модель записи.
Настройки голоса вне диапазона провайдера
У ElevenLabsspeed принимает только 0,7–1,2, а stability, similarity_boost и style — 0,0–1,0:
- Значение вне диапазона подтягивается к ближайшей границе. Например,
speed1,4 звучит как 1,2. - Нечисловое значение не отправляется, и провайдер использует своё значение по умолчанию.
use_speaker_boostпринимает да/нет. - Проверка перед публикацией и перед запуском кампании предупреждает об обоих случаях: «…будет говорить с speed 1.2 вместо 1.4» или «…настройка не будет отправлена». Это предупреждения: агента всё равно можно опубликовать, а кампанию — запустить.
speed, stability, similarity_boost, style и use_speaker_boost — можно писать и в «Параметры вне паспорта (JSON)»; там они важнее полей «Скорость» и «Тонкой настройки».
Параметры голоса ElevenLabs
У голоса ElevenLabs в окне выбора голоса есть поля, которые управляют звучанием: скорость — в панели голоса, остальные — в «Тонкой настройке».
За эмоциональность отвечают
stability и style. Главный рычаг — stability: чтобы агент звучал живее, начните с 0,35–0,4 при style 0. Если этого мало, добавьте style 0,1–0,2 — выше в живом звонке обычно заметна задержка. На быстрых моделях, в том числе на модели по умолчанию eleven_flash_v2_5, style может почти не влиять на звучание.
VAD и перебивания
VAD (voice activity detection) определяет начало и конец речи, а настройки перебивания управляют тем, может ли абонент оборвать агента. Параметры читаются при старте звонка, пересобирать ничего не нужно. Группа «Очерёдность реплик» карточки «Голос»:- «Разрешить перебивание» — может ли абонент перебить агента. Под переключателем всегда стоят два поля:
- «Мин. длительность», с (
min_interruption_duration) — сколько речи нужно, чтобы перебить. Пустое поле — авто: значение выбирается при старте звонка по ASR агента; поле показывает его подсказкой. - «Мин. слов» (
min_interruption_words) — сколько распознанных слов должен произнести абонент, прежде чем агент замолчит; 0 — проверки слов нет. Пустое поле — авто, по тому же правилу.
- «Мин. длительность», с (
- «Конец реплики» — «Мин. задержка конца реплики» и «Макс. задержка конца реплики», с: минимальное ожидание после конца речи клиента, прежде чем ход считается завершённым, и максимальное, после которого ход завершается в любом случае. Пустое поле берёт дефолты режима определения конца реплики; поле показывает их подсказкой. «Сбросить задержки к дефолтам режима» очищает оба поля.
- «Фильтр по громкости» — вторая проверка речи: тихий кадр не начнёт запись реплики, даже если модель сочла его речью. Помогает на шумной линии.
- «Настройки VAD во время звонка» — пороги детектора речи по состояниям агента; см. ниже.
- «Предбуфер», с (
prefix_padding_duration) — сколько звука сохраняется перед обнаруженной речью. - «Макс. буфер», с (
max_buffered_speech) — самая длинная реплика, которую агент держит в памяти. - «Частота дискретизации» (
sample_rate) — 8000 для узкополосной телефонии, иначе 16000.
«Авто»: умолчания под вашу модель распознавания
Потоковая модель отдаёт текст по ходу речи, пакетная — целиком, когда абонент договорил (см. «Промежуточные результаты» в секции STT). Одни и те же пороги перебивания для них не годятся: на пакетной модели слова можно сосчитать только после паузы абонента, поэтому словесный гейт откладывает перебивание до конца фразы. Оставленное пустым поле означает «авто» — платформа подставляет набор под ту модель, которую вы выбрали в STT:
Введённое число всегда сильнее «авто»: ваше значение платформа не трогает. Порог длительности на всех ветках отдельным полем не настраивается — он идёт вместе с набором.
Пороги по состояниям агента и фильтр по громкости
«Настройки VAD во время звонка» в шестерёнке «Параметры очерёдности реплик» — таблица правил: те же пороги, но по состояниям агента. В ней две строки: «Когда агент говорит или думает» и «Остальные состояния». Колонки — «Вход» (activation_threshold), «Выход» (deactivation_threshold) и «Тишина» (min_silence_duration). Кнопка ⋯ в конце строки открывает «Остальные поля»: min_speech_duration и — пока включён фильтр по громкости — три поля громкости activation_volume, deactivation_volume и release_hold; без фильтра платформа их не применяет. Пустое поле показывает подсказкой значение, которое действует: в первой строке — значение «Остальных состояний», во второй — умолчание платформы. Набор самих правил задан кодом, меняются только числа. Если сочетание значений неверно, под строкой появляется предупреждение.
Состояния агента. Во время звонка агент всё время находится в одном из пяти состояний — их названия видны под названием правила:
Пороги переключаются сразу, как только меняется состояние. Два правила нужны, чтобы детектор речи мог быть строже, пока агент говорит или готовит ответ: в это время в линию попадают эхо голоса агента, шум и короткие «угу», которые не должны засчитываться как реплика абонента и обрывать агента. Пока агент слушает, детектор остаётся чувствительным, чтобы не пропустить тихий ответ.
Что значат пороги (одинаково в обоих правилах):
activation_threshold— уверенность детектора, что в звуке речь, от 0 до 1, при которой он засчитывает начало речи. По умолчанию 0,5. Чем выше, тем увереннее должна звучать речь: шум и эхо реже принимаются за абонента, но тихий или отрывистый ответ тоже может не засчитаться.deactivation_threshold— уверенность, ниже которой речь считается закончившейся. Должен быть ниже порога входа, чтобы речь не рвалась на паузах между словами. Пустое поле — порог входа минус 0,15, то есть 0,35 при пороге 0,5.min_speech_duration, сек («Остальные поля») — сколько звук должен продержаться выше порога, чтобы детектор засчитал начало речи. По умолчанию 0,05. Больше — короткие щелчки и «угу» не засчитываются, но и начало ответа фиксируется чуть позже.min_silence_duration, сек (колонка «Тишина») — сколько тишины считается концом реплики. По умолчанию 0,55.
activation_volume (0,01) мгновенно, а закрывается на deactivation_volume (0,005) не сразу: release_hold, сек (0,3) — сколько уровень должен продержаться низким, прежде чем фильтр закроется. Удержание нужно как раз для тихого абонента: его голос проседает на спаде каждого слога, и без паузы на закрытие фильтр рвал бы речь по слогам. Поставьте 0, если хотите, чтобы фильтр закрывался на первом же тихом кадре.
Определение конца реплики
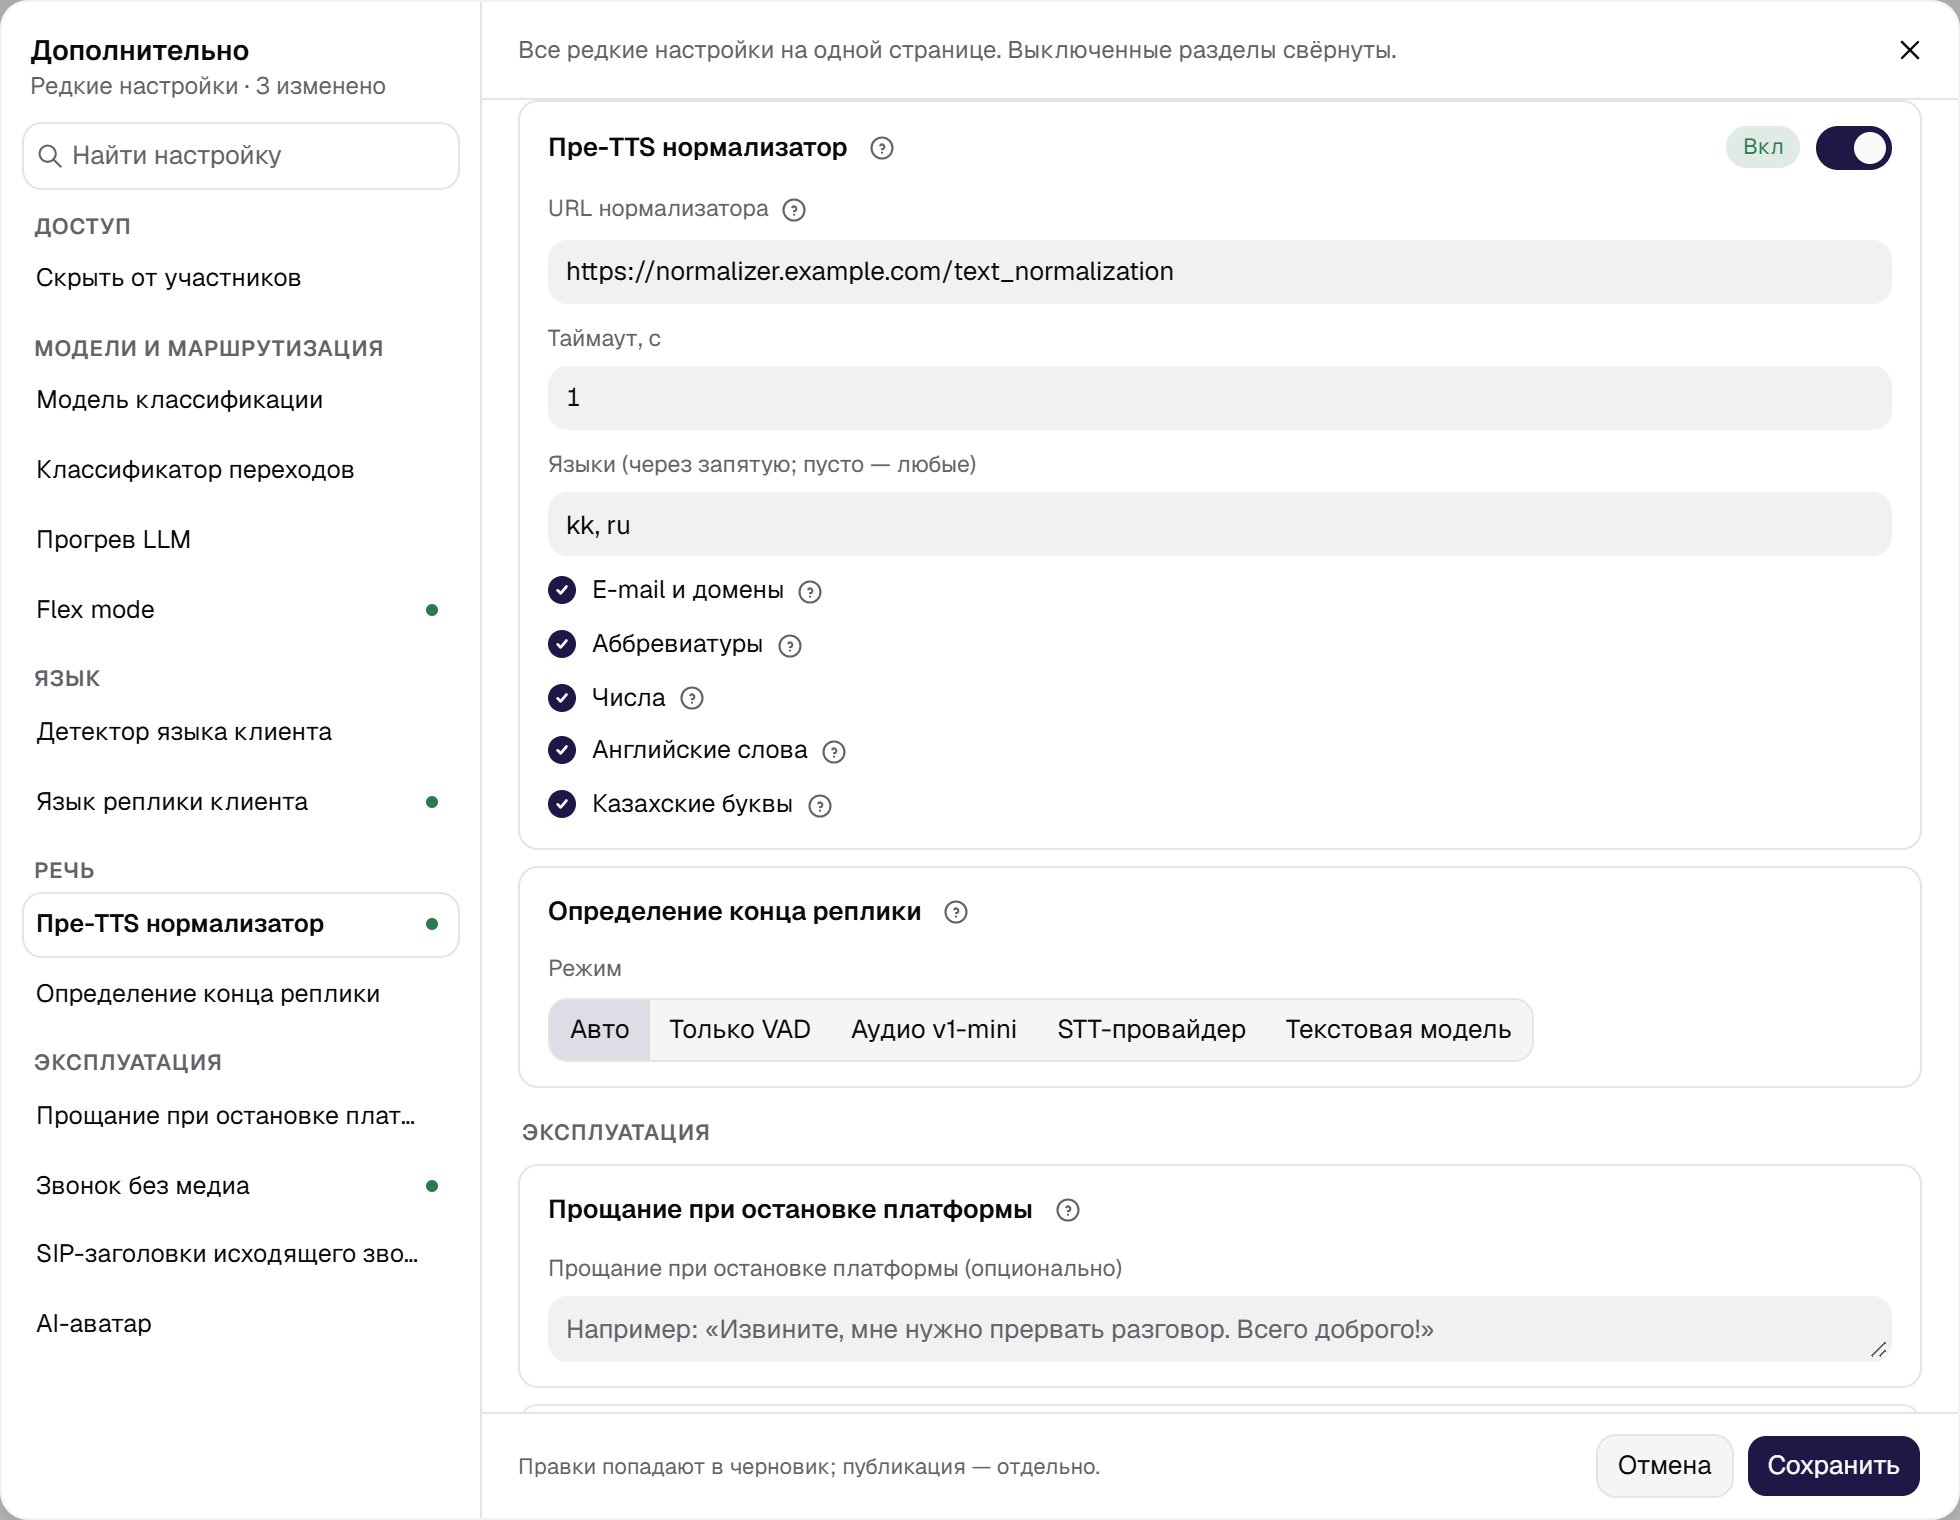
Как определять, что клиент договорил. Раздел находится в «Дополнительно» → «Речь» → «Определение конца реплики». «Режим» выбирается одним из пяти сегментов; полное название видно при наведении:- «Авто» — значение сервера; поведение существующих агентов не меняется.
- «Только VAD» — конец реплики по тишине. Рекомендован, когда язык вне поддержки детекторов, например казахский.
- «Аудио v1-mini» — локальная аудио-модель, которая слушает интонацию, ритм и паузы. Русского и казахского нет среди поддерживаемых ею языков. Добавляет «unlikely_threshold (скаляр)» и «Пороги по языкам (JSON)».
- «STT-провайдер» — решает провайдер ASR. «Мин. задержка конца реплики» добавляется к его собственной задержке, и ожидания складываются.
- «Текстовая модель» — единственный режим с поддержкой русского; модель помечена устаревшей. Добавляет «unlikely_threshold (скаляр)».
Активное слушание
«Активное слушание» — переключатель в группе «Очерёдность реплик». Во время длинной речи клиента агент произносит короткие подтверждающие слова вроде «угу». Это не реплика диалога: слово идёт отдельным аудиотреком, не попадает в транскрипт и не влияет на определение конца реплики.- «Частота срабатывания (0..1)» — как часто оно срабатывает.
- «Слова (через запятую)» — пусто — дефолтный набор на текущем языке звонка; свой список применяется как есть.
Правки фраз
Переключатель «Правки фраз» в группе «Очерёдность реплик» применяет словарь замен организации к репликам этого агента. См. Правки фраз и паузы.Фоновый звук
Фоновая запись — например, офисный шум — подмешивается в голос агента и делает разговор естественнее. Она проигрывается бесшовным лупом на всю длительность звонка и на распознавание не влияет: фон никогда не анализируется как речь, поэтому ни определение речи абонента, ни транскрипт от него не меняются.- «Фоновый звук» — переключатель в группе «Очерёдность реплик». Поля ниже появляются, когда он включён.
- «Аудио-ассет» — выбор записи. В списке две группы:
- «Стандартные» — фоны платформы, одинаковые для всех организаций: «Клавиатура» и «Клавиатура, короткая»;
- «Загруженные» — файлы вашей организации. «Загрузить аудио… (wav/mp3/ogg/opus)» добавляет новый: он сразу становится доступен всем агентам организации. Удалить загруженный файл из агента нельзя.
- «Громкость фона» — уровень подмешивания относительно голоса агента.
Пре-TTS нормализатор
Приводит адреса электронной почты, аббревиатуры, числа и латиницу к произносимой форме перед синтезом. Раздел находится в «Дополнительно» → «Речь» → «Пре-TTS нормализатор».- Переключатель в заголовке раздела включает нормализатор. Адрес сервиса нормализации задаёт платформа.
- «Таймаут, с» — сколько ждать ответа сервиса нормализации.
- «Языки (через запятую; пусто — любые)» — ограничение по языкам.
- «E-mail и домены», «Аббревиатуры», «Числа», «Английские слова», «Казахские буквы» — что нормализовать.