

Голос: распознавание, синтез, перебивания
Цель модуля: настроить голос агента так, чтобы он слышал клиента, звучал естественно и вовремя замолкал — на одном языке или на двух в одном звонке.
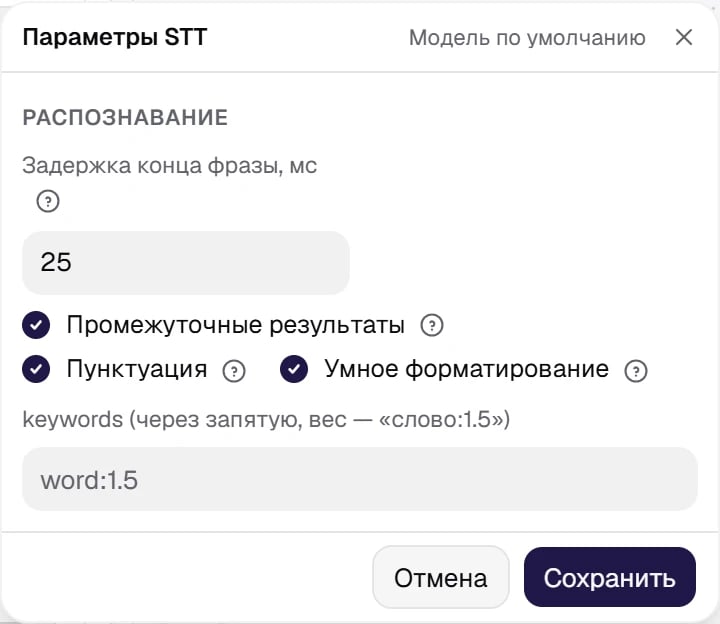
STT — что агент слышит: параметры модели и провайдера. Модель распознавания выбирается из справочника.
Показать панель целиком
Показать панель целиком
- подсказки уходят в распознавание, только если паспорт параметров выбранной модели объявляет
keywords; иначе проверка перед публикацией предупредит, что они не отправляются; - фраза — от 3 до 80 символов, не больше 10 слов, только кириллица, без латиницы, цифр и повторов; фразу вне этих правил сервис отбрасывает, и проверка об этом предупреждает;
- фраз больше, чем принимает модель, — ошибка проверки: такой запрос сервис отклонил бы целиком.
- кириллицей; казахские буквы тоже можно — «салық», «төлем»;
- числа — словами: «два ноль», а не «2.0»;
- аббревиатуру, которую читают словом, — заглавными: «ЦОН», «ИИН»;
- аббревиатуру, которую читают по буквам, — буквами: «ка эн пэ», а не «КНП».
- для банка —
эквайринг, овердрафт, кэшбэк, ИИН, ЦОН, ка эн пэ, свифт перевод; - для клиники в Казахстане —
Шипагер, эндокринолог, анализ на гемоглобин, ЭКГ; - для клиники в США —
Medicaid, Dr. Ramirez.
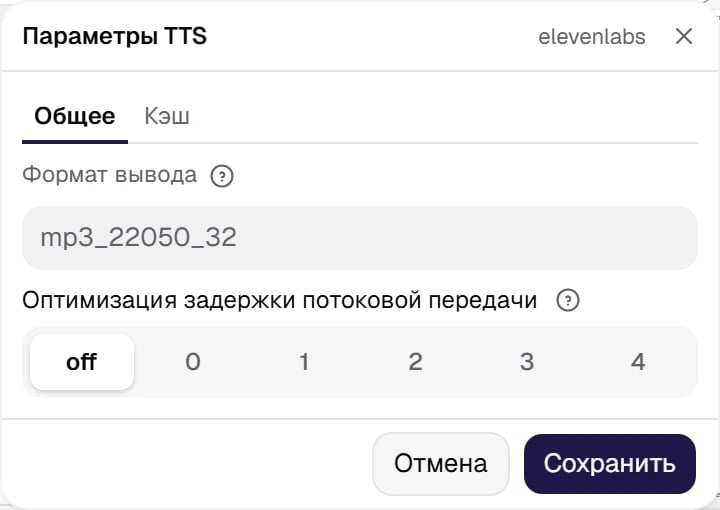
TTS — как агент звучит. В шестерёнке — формат вывода и оптимизация задержки. Сам голос, его модель и настройки выбираются в окне выбора голоса, а резервный голос — в «Дополнительно» → «Резервные сервисы».
Показать панель целиком
Показать панель целиком
apply_text_normalization. Значение вне диапазона паспорта кабинет подсвечивает и не сохраняет, а параметр, отвергнутый паспортом, блокирует публикацию. Паспорт голоса cybernet строгий: поля для дополнительных ключей в нём нет, и ключ, которого паспорт не знает, тоже блокирует публикацию — сервис молча принял бы ключ с опечаткой. У голоса cybernet при «Скорости» 0,9 и ниже кабинет предупреждает, что качество голоса падает.
Числа, даты и сокращенияКак голос прочитает «12:30» или «$49.99», решает нормализация текста у провайдера синтеза:
- cybernet —
apply_text_normalizationсо значениямиonиoff. Когда у агента задан язык разговора, сервис раскрывает числа, сокращения и латиницу только приon. Если агент называет суммы, даты или время, выберитеon; учтите, чтоonможет увеличить время до первого звука. - ElevenLabs — тот же
apply_text_normalizationсо значениямиauto,onиoff; приautoрешает вендор. - Inworld —
text_normalizationсо значениямиONиOFF.
Два языка в одном звонкеКлиент может начать на одном языке и перейти на другой: в Казахстане — например, с русского на казахский (
ru/kk), в США — с английского на испанский (en/es). Чтобы это работало:- Языки агента — отметьте оба языка в поле «Языки агента» карточки «Агент и промпт». Первый — основной: с него начинается звонок. Оставьте включённым «Автопереход на язык клиента» — агент сам переходит на язык, на котором заговорил клиент, и отвечает на нём; голос, распознавание и встроенные фразы переключаются вместе с ним.
- STT — модель, которая распознаёт оба языка. Для
kk/ruподходят, например, Soniox Real-time (сама определяет язык и переключается внутри реплики) и модели Cybernet KZ/RU; дляen/es— Deepgram Nova-3, Soniox Real-time, AssemblyAI Universal-3.6 Pro (streaming), Gladia Solaria-1 (live) и Azure Speech STT. Окно выбора само оставляет только модели, которые знают оба языка. - TTS — голос, который говорит на обоих языках. Для
kk/ru— голоса cybernet и Soniox; дляen/es— голоса ElevenLabs, Cartesia, Inworld и Soniox. - Совет: фиксированные фразы пишите на основном языке — с него начинается звонок.
kk/ru язык клиента определяется по казахским буквам в реплике. Короткая казахская фраза без них, например «саламатсыз ба», оставляет звонок на русском, пока клиент не скажет фразу с казахскими буквами.VAD и перебивания
В группе «Очерёдность реплик» настраивается, как агент реагирует, когда клиент заговорил поверх него:- «Разрешить перебивание» — общий переключатель агента; узел может задать своё значение.
- «Мин. длительность» и «Мин. слов» — защита от ложных срабатываний: кашель, «ага» и шум в трубке не должны обрывать реплику агента.
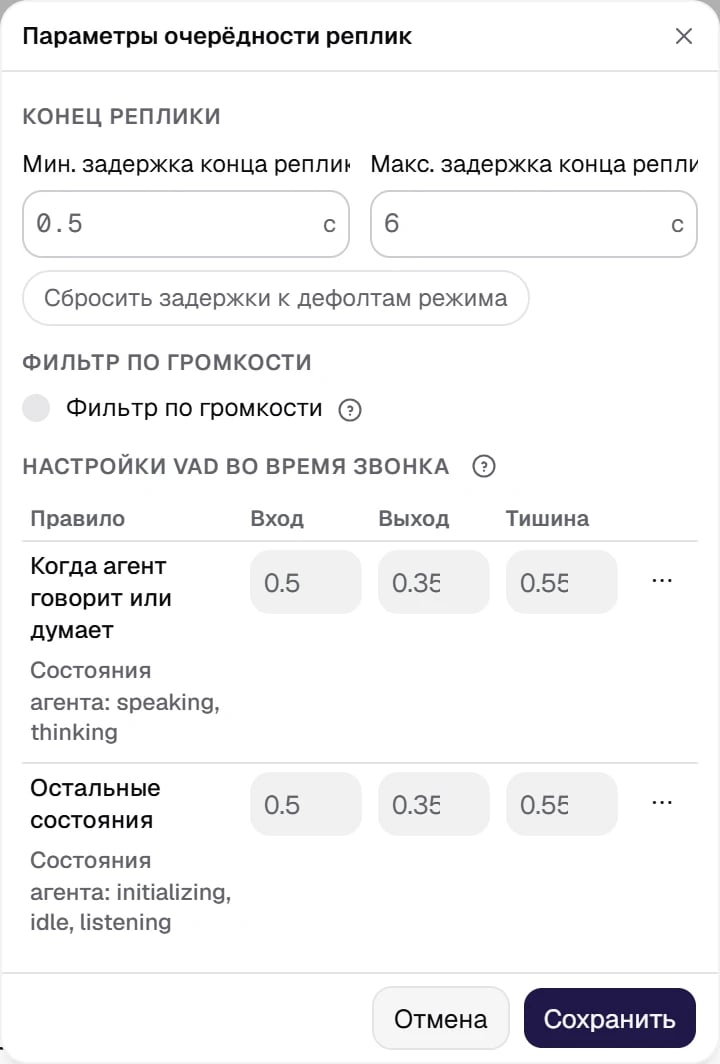
Шестерёнка «Параметры очерёдности реплик»: задержки конца реплики, фильтр по громкости и пороги детектора речи по состояниям агента.
Показать панель целиком
Показать панель целиком
kk— «Только VAD»: конец реплики по тишине; кабинет рекомендует его, когда язык вне поддержки детекторов.ru— «Текстовая модель»: единственный режим с поддержкой русского; модель помечена устаревшей.enиes— «Аудио v1-mini»: аудио-модель слушает интонацию, ритм и паузы и знает английский и испанский. Или «STT-провайдер», если модель распознавания — Deepgram, Soniox, Azure или AssemblyAI: конец реплики определяет провайдер.
ru — «угу», «ага», «мгм», для kk — «иә», «жарайды», для en — «uh-huh», «mhmm», «okay», для es — «ajá», «mhm», «vale». «Частота срабатывания (0..1)» по умолчанию 0,8. Совет: 0,6 — разумная середина, 1,0 звучит навязчиво. Точнее всего момент для подтверждения выбирается с моделями Deepgram, Soniox и Azure; с остальными, в том числе с пакетными Cybernet, кабинет предупреждает, что слова могут звучать менее естественно.
Кэш синтеза отдаёт уже озвученные фразы без повторного синтеза; он включён по умолчанию. У голосов ElevenLabs, Cartesia, Inworld и cybernet фиксированные фразы без переменных озвучиваются заранее, при публикации, поэтому приветствие звучит без задержки синтеза уже в первом звонке; у Soniox и Azure кэш наполняется во время звонков. Совет: «Фраза» вместо «Промпта» в начале разговора — не только про формулировки, но и про скорость.
Пауза в речи —
[pause N]Между словами можно поставить [pause 0.5], и агент остановится на полсекунды; допустимы значения от 0,1 до 3,0. Это способ прочитать номер телефона группами, а не одной строкой, и дать абоненту мгновение перед вопросом, требующим решения.Тег понимают и фиксированный текст узла, и генерируемые реплики — модели можно прямо в промпте сказать, когда ставить паузу. В транскрипт, Историю и отчёты тег не попадает: его видит только синтез.Но длина паузы зависит от голоса. ElevenLabs (кроме моделей eleven_v3, eleven_v3_conversational, eleven_v4 и eleven_v4_turbo), Cartesia, Inworld и Azure держат паузу точной длины. Soniox, голоса cybernet и ElevenLabs на этих четырёх моделях так не умеют, и там тег превращается в запятую или многоточие — остановка слышна, но [pause 2] и [pause 0.5] звучат одинаково. У realtime-агента пауз не будет вовсе, валидатор об этом предупредит. Проверяется ушами: сделайте тестовый звонок, транскрипт пауз не покажет. Подробности — в правках фраз и паузах.